Blog
Architecture médaillon : organiser un Data Warehouse avec Microsoft Fabric
Appliquer l'architecture médaillon (Bronze, Silver, Gold) dans un Data Warehouse Microsoft Fabric unique, plutôt que sur des données dispersées entre plusieurs zones.
5 min de lectureZakaria OBOUHO
- Microsoft Fabric
- Data Warehouse
- Lakehouse
- Power BI
- Business Intelligence
- Gouvernance des données
Dans les projets modernes de Data Engineering et de Business Intelligence, l’un des principaux défis consiste à organiser les données de manière fiable, évolutive et facilement exploitable. L’architecture médaillon (Medallion Architecture) est un modèle particulièrement adapté pour faire évoluer les données de leur état brut vers des données propres, enrichies et prêtes pour l’analyse.
Dans de nombreux environnements (dont Microsoft Fabric), ce modèle est souvent implémenté en répartissant chaque couche sur un composant différent — un Lakehouse par zone, par exemple. Cet article présente une approche alternative : centraliser les trois couches directement dans le Data Warehouse, afin de simplifier la gouvernance, l’accès SQL et la maintenance.
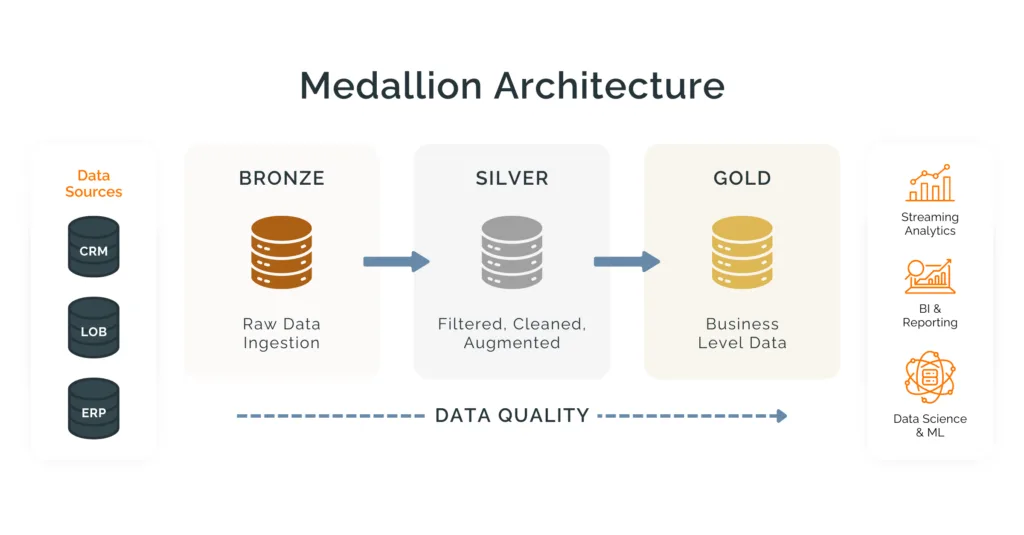
Qu’est-ce que l’architecture médaillon ?
Elle repose sur trois couches de transformation, complétées par une couche de consommation :
- Bronze : données brutes, telles que reçues des sources (ERP, CRM, fichiers…).
- Silver : données nettoyées, dédupliquées et standardisées.
- Gold : données structurées pour les besoins métiers (dimensions, faits, KPIs).
- BI (consommation) : visualisation via Power BI, rapports et tableaux de bord.
Pourquoi centraliser les trois couches dans le Data Warehouse ?
Plutôt que de répartir Bronze, Silver et Gold sur des zones de stockage distinctes (par exemple un Lakehouse par couche), il est possible de regrouper l’ensemble du cycle de vie de la donnée dans le Data Warehouse, sous forme de tables et de vues successives. Cette centralisation apporte plusieurs avantages concrets :
- Un point d’entrée SQL unique pour tous les outils (Power BI, requêtes ad hoc, procédures) sans dépendre d’un moteur ou d’un lac de données externe.
- Une gouvernance simplifiée puisque les droits d’accès, le schéma et le catalogue sont gérés à un seul endroit.
- Un contrôle précis du schéma cible en créant les tables vides avant le chargement, plutôt que de laisser le schéma s’inférer automatiquement.
- Moins de duplication et de latence entre les couches, puisque les transformations Silver → Gold s’exécutent directement dans le Warehouse (procédures ou dataflows).
Bronze — Raw
La couche Bronze contient les données telles qu’elles arrivent des systèmes sources.
Silver — Nettoyage et intégration
Les données Bronze sont transformées et consolidées dans une table intermédiaire du Data Warehouse. Exemples de traitements appliqués :
- suppression des doublons ;
- gestion des valeurs nulles ;
- normalisation des formats ;
- conversion des types ;
- contrôle qualité ;
- rapprochement entre sources (ex. Salesforce ↔ ERP) ;
- application des premières règles métier.
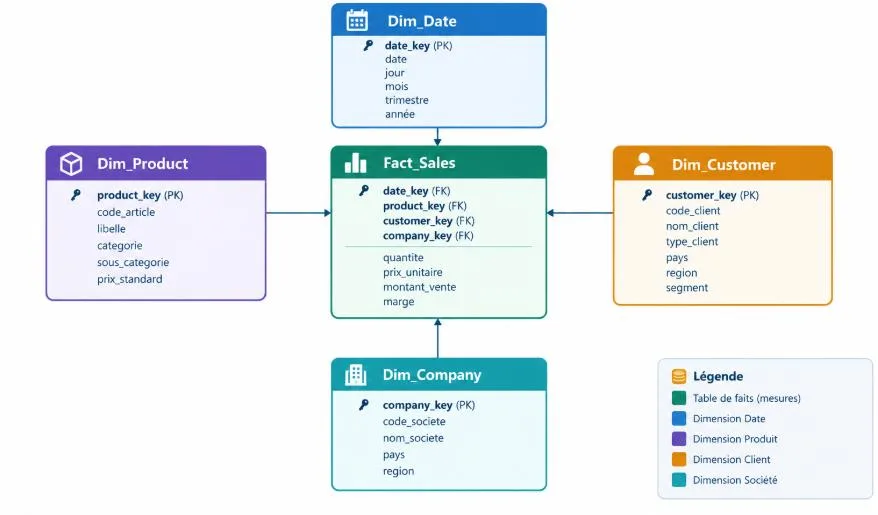
Gold — Modèle métier
La couche Gold expose les données directement exploitables par les métiers et par Power BI, sous forme de vue ou de table physique dans le Data Warehouse. On peut construire un modèle en étoile :
Centralisation concrète dans le Data Warehouse
Dans un projet concret, l’ingestion brute peut transiter par un Lakehouse, mais l’ensemble du traitement médaillon — réception, nettoyage, exposition — est ensuite centralisé dans le Data Warehouse, sous forme de tables vides créées à l’avance puis remplies via un Copy Data dans un Pipeline. La correspondance est la suivante :
| Couche médaillon | Objet dans le Data Warehouse | Rôle |
|---|---|---|
| Bronze | stg table |
Réception des données copiées depuis les sources (via Lakehouse ou directement), avant tout nettoyage |
| Silver | table cleaned |
Données dédupliquées, typées, standardisées, avec application des règles métier |
| Gold | view finaldata |
Vue métier finale, exposée directement à Power BI via le endpoint SQL du Warehouse |
Mise en œuvre technique : pipeline et procédures stockées
L’automatisation du flux repose sur deux briques simples, toutes deux centrées sur le Data Warehouse :
- Un Pipeline orchestre le chargement : une activité Copy Data copie les données depuis la source (ou le Lakehouse d’ingestion) directement vers les
stg tablesdu Warehouse, sans transformation. - Des procédures stockées (stored procedures) SQL, créées dans le Warehouse, appliquent ensuite les transformations Bronze → Silver : dédoublonnage, typage, normalisation, règles métier, pour produire les tables
cleaned. - Une procédure stockée (ou vue) supplémentaire construit la couche Gold (
finaldata) à partir des tablescleaned, prête à être consommée par Power BI. - Le Pipeline enchaîne l’activité Copy Data puis l’exécution des procédures stockées (activité Stored Procedure), ce qui automatise tout le flux Bronze → Silver → Gold sans jamais sortir du Data Warehouse.
Flux centralisé mis en œuvre :
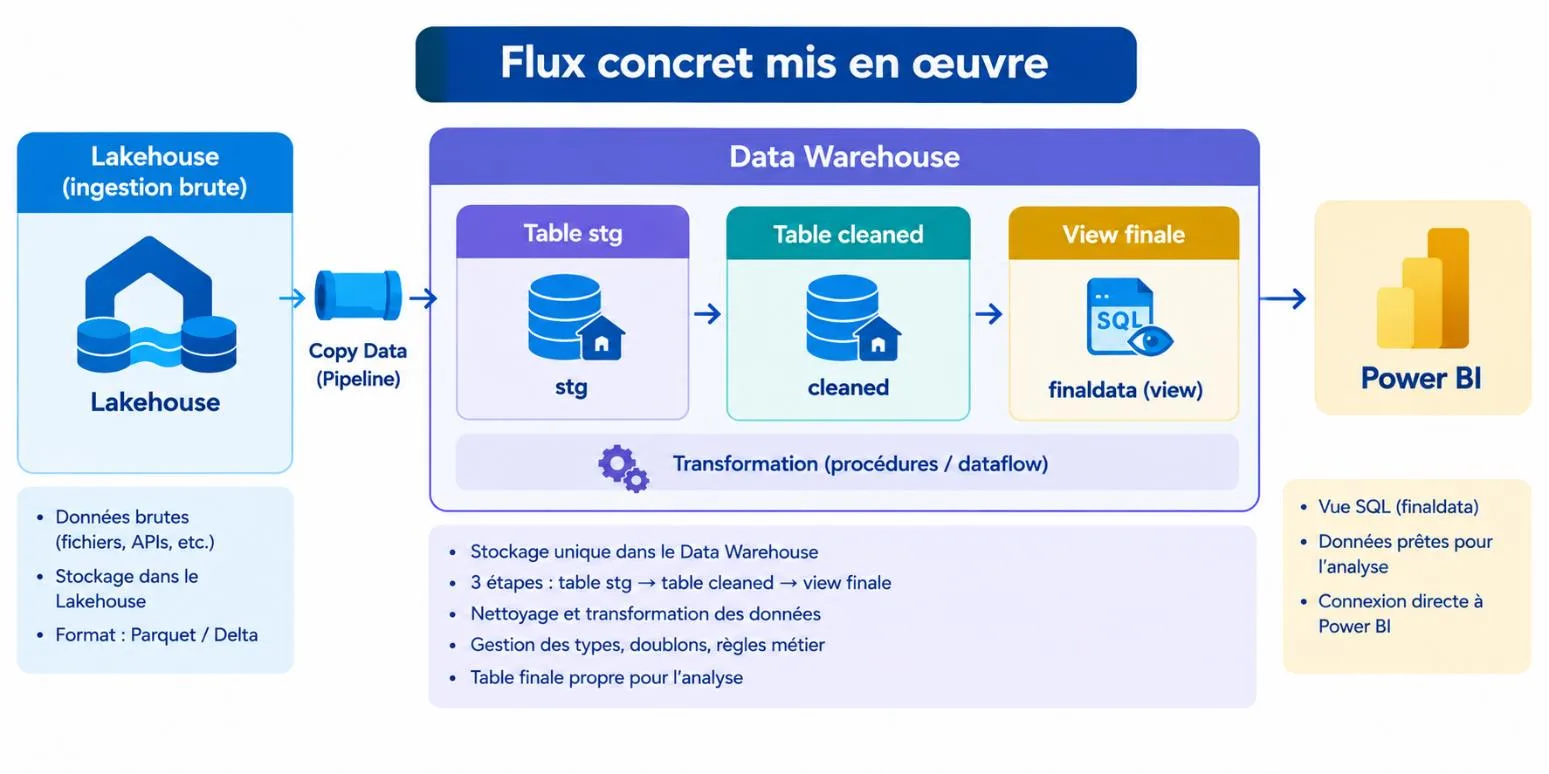
Remarques : créer les tables vides avant le Copy Data permet de contrôler précisément le schéma cible plutôt que de le laisser s’inférer automatiquement. La
stg tablejoue le rôle d’une zone Bronze directement dans le Warehouse, ce qui évite aux outils SQL de dépendre d’un accès externe au Lakehouse. La vuefinaldatareste légère et à jour en continu ; si le volume devient important, matérialiser cette couche Gold en table physique — toujours dans le même Data Warehouse — peut améliorer les performances sans jamais sortir de l’entrepôt central.
Conclusion
Le véritable intérêt de l’architecture médaillon n’est pas de créer trois couches pour la forme, mais de séparer clairement les responsabilités à chaque étape du cycle de vie de la donnée. En centralisant ces trois couches dans un Data Warehouse unique, on obtient des données plus fiables, gouvernées, maintenables et performantes, tout en simplifiant l’infrastructure et l’accès SQL.
RAW → CLEAN → BUSINESS → ANALYTICS
Bronze conserve la vérité de la source, centralisée dans le Warehouse. Silver construit la qualité, sans quitter le Warehouse. Gold construit la valeur métier, exposée directement du Warehouse vers Power BI.