Use case
Automatiser sans sur-architecturer : retour d'expérience sur un projet supply chain
Power Automate et Azure pour automatiser les cotations d’un acteur supply chain : −85 % de temps de traitement, −94 % d’erreurs, booking en moins de 2 minutes.
5 min de lectureMouhcine EL HASNAOUI
- Power Automate
- Azure
- Event-Driven Architecture
- Supply chain
Lundi matin, 8h15. Une journée entière pour une seule opération logistique.
Karim, coordinateur supply chain, reçoit une commande urgente à expédier avant la fin de semaine. Il ouvre Outlook, copie-colle les détails depuis un fichier Excel, envoie ses demandes de cotation à la main. Les réponses arrivent en ordre dispersé. Il extrait les données, construit son comparatif, attend la validation de son manager. À 17h45, une seule opération logistique a occupé l’essentiel de sa journée.
Maintenant, imaginez ce même processus automatisé : la commande est enregistrée, les cotations partent instantanément, les réponses sont consolidées, le manager valide en un clic, le transporteur est notifié. En moins d’une heure. Sans intervention manuelle.
Ce n’est pas exceptionnel — c’est ce que l’automatisation événementielle rend possible aujourd’hui. Dans cet article, vous verrez comment nous l’avons concrètement mis en œuvre pour un client du secteur supply chain avec Power Automate et Azure, de la conception de l’architecture à la mise en production, avec les résultats mesurés à la clé.
Le problème : quand les workflows manuels coûtent plus cher qu’on ne le croit
Le retard à l’automatisation n’est plus une option neutre — c’est un désavantage compétitif mesurable. Selon Gartner, 38 % des entreprises prévoient déjà de basculer vers l’automatisation intelligente pour la logistique, la distribution et la production dans les trois prochaines années. Celles qui n’ont pas encore amorcé cette transition subissent l’écart — souvent sans le quantifier.
Notre client gérait ses flux de cotation et ses opérations manuellement. Les conséquences concrètes étaient au nombre de trois :
- Des délais de traitement de 4 à 8 heures par cotations.
- Un taux d’erreurs de saisie de 8 % — chaque erreur générant des aller-retours avec les transporteurs.
- Une absence totale de traçabilité : impossible de savoir, à tout instant, où en était une demande.
Automatisation des workflows : les fondamentaux
Tâche isolée vs workflow complet : deux niveaux de valeur très différents
Automatiser une tâche, c’est envoyer un courriel de confirmation après réception d’un formulaire. Automatiser un workflow, c’est enchaîner : réception d’un fichier → validation du format → identification des destinataires → distribution → archivage → notification de statut. Le gain n’est pas linéaire, il est exponentiel.
Tout workflow automatisé repose sur un modèle universel en trois temps
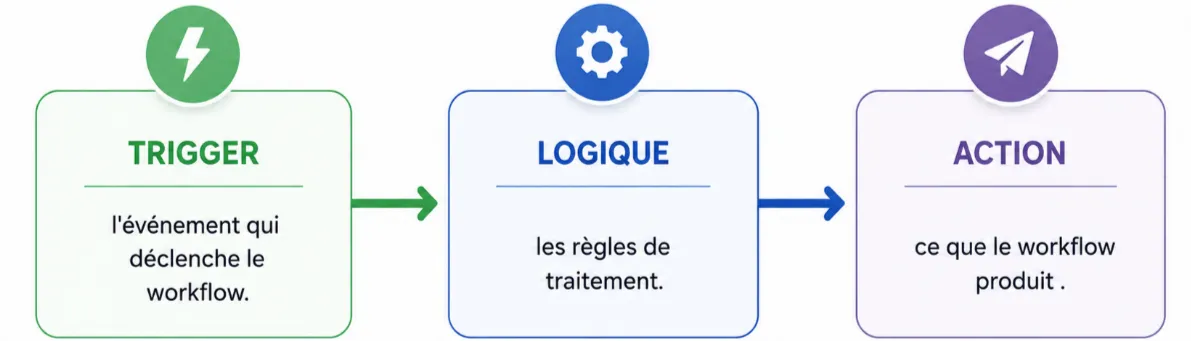
L’architecture événementielle : pourquoi elle change tout
De l’automatisation planifiée à l’automatisation réactive
Une architecture pilotée par les événements (Event-Driven Architecture, ou EDA) est un modèle dans lequel les systèmes réagissent à des faits — des événements — plutôt qu’à des horaires planifiés ou des requêtes directes.
L’automatisation classique est statique : un flow s’exécute à heure fixe, ou sur déclenchement manuel. L’EDA rend l’automatisation réactive : le système agit dès que quelque chose se passe, sans attendre.
Polling vs Event-Driven : choisir le bon pattern pour votre contexte
C’est la question architecturale centrale. L’event-driven n’est pas systématiquement supérieur au polling — ce sont deux patterns légitimes avec des compromis très différents. Choisir le mauvais coûte cher : soit en latence (polling sous-dimensionné), soit en complexité opérationnelle (EDA surdimensionné).
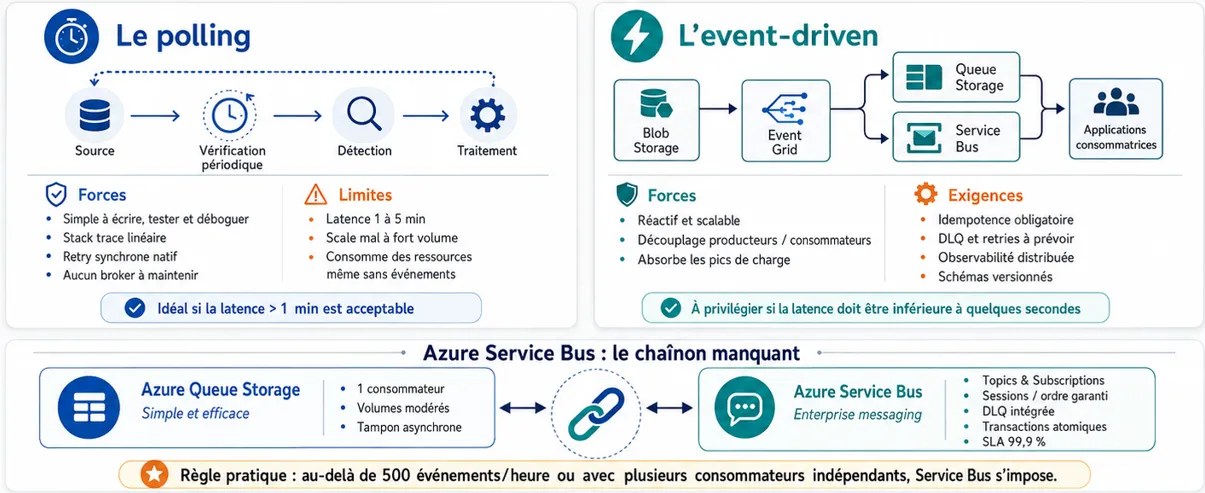
Polling ou event-driven : le bon choix dépend du niveau de latence attendu, du volume d’événements et du nombre de consommateurs.
Notre approche : partir du besoin, pas de la technologie
Chez We Are Beebay, notre point de départ n’est jamais la technologie. Il est toujours le besoin.
Choisir un outil parce qu’il est tendance, c’est prendre le risque de construire une solution techniquement correcte mais déconnectée des contraintes réelles du client. Notre démarche consiste à qualifier chaque flux selon quatre critères avant de recommander quoi que ce soit :
- Volume : combien d’événements par jour, avec quels pics prévisibles ?
- Criticité : qu’est-ce qui se passe si un message est perdu ou traité en retard ?
- Latence acceptable : le traitement peut-il attendre 5 minutes, ou doit-il être quasi-instantané ?
- Écosystème existant : quels outils et licences sont déjà en place ?
- Complexités opérationnelles : ce que l’event-driven exige en production
L’architecture retenue : un pipeline en 6 étapes
L’architecture présentée ci-dessous illustre l’une des réponses pouvant être apportées à ce type de problématique. Dans ce projet, les choix réalisés résultent d’arbitrages entre réactivité, maintenabilité et simplicité opérationnelle, en tenant compte des contraintes métier et de l’écosystème existant. Le résultat est un pipeline hybride en six étapes, combinant des mécanismes événementiels et des traitements pilotés par du polling, depuis la réception du fichier jusqu’à son exploitation dans l’application métier.
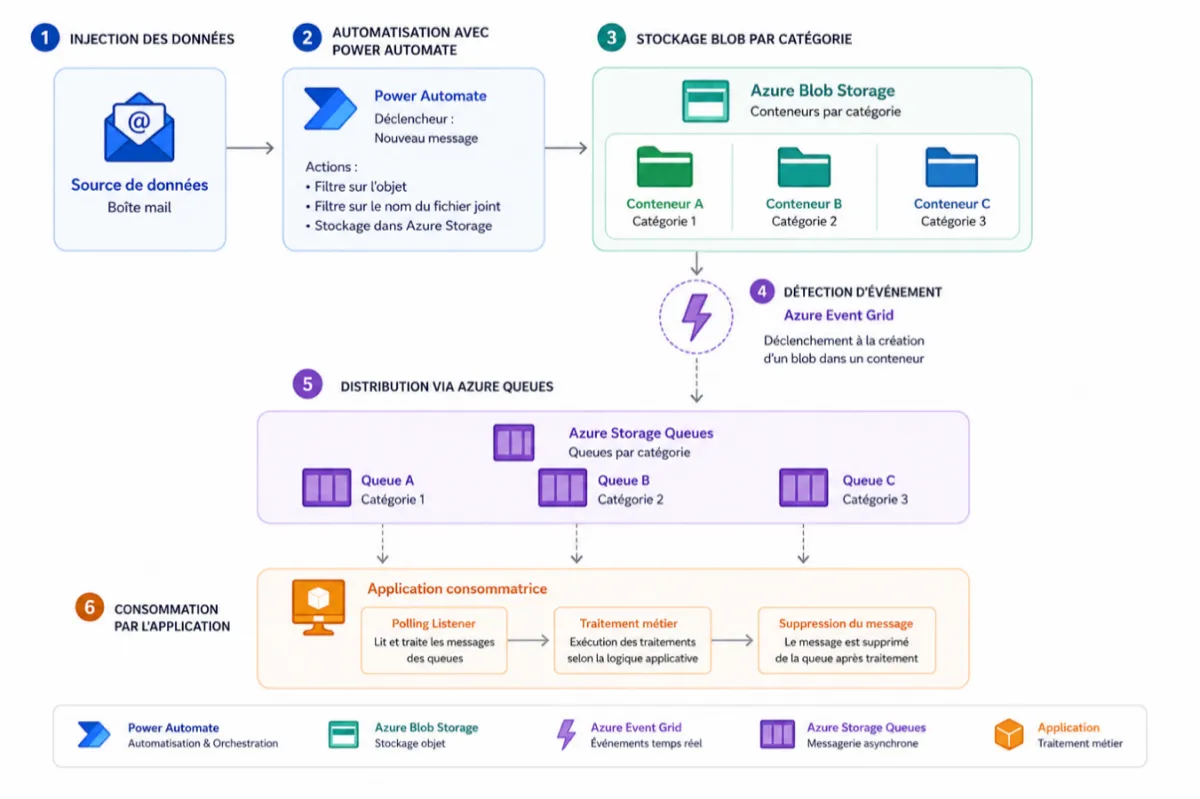
Architecture hybride en six étapes, de la réception des données jusqu’au traitement métier, avec Power Automate et les services Azure.
Ce choix résulte directement de l’analyse des besoins du client. Trois critères ont guidé la décision :
- Le volume d’événements quotidiens restait modéré ;
- Un seul consommateur traitait les messages en aval ;
- Les contraintes de latence — quelques minutes au maximum — étaient parfaitement compatibles avec un polling régulier.
Dans ce contexte, la complexité opérationnelle supplémentaire qu’aurait introduite Azure Service Bus n’était pas justifiée. Azure Storage Queues offrait la simplicité, la fiabilité et le niveau de découplage suffisant pour répondre aux exigences du projet.
Quand Azure Service Bus devient le bon choix
Dans d’autres contextes, l’étape 5 pourrait s’appuyer sur Azure Service Bus Queues ou Topics/Subscriptions à la place des Azure Storage Queues, et l’étape 6 reposerait alors sur un Service Bus Listener plutôt que sur un Polling Listener. Ce basculement se justifie lorsque le projet présente l’un des besoins suivants :
- Découplage avancé : Besoin d’une isolation plus forte entre les composants de l’architecture.
- Garantie d’ordre : Traitement strict des messages selon leur ordre d’arrivée.
- Modèle Pub/Sub : Plusieurs consommateurs indépendants doivent traiter le même message (Topics/Subscriptions).
- Haute fiabilité : Exigences accrues en matière de sécurité, de transactions et de garanties de livraison.
Résultats : ce que les chiffres disent
Après la mise en production de notre pipeline d’automatisation et son intégration avec l’application métier développée sur mesure et adaptée aux besoins, voici les mesures observées sur les opérations liées à l’export et à la supply chain :
| Indicateur | Avant | Après | Gain |
|---|---|---|---|
| Traitement d’une demande de tarification | 4 à 8 heures | < 1 heure | −85 % |
| Taux d’erreurs de saisie | ~8 % | < 0,5 % | −94 % |
| Délai de booking | Plusieurs heures | < 2 minutes | Temps réel |